

Garbage in, garbage out: waarom AI en marketing automation falen zonder dataverificatie
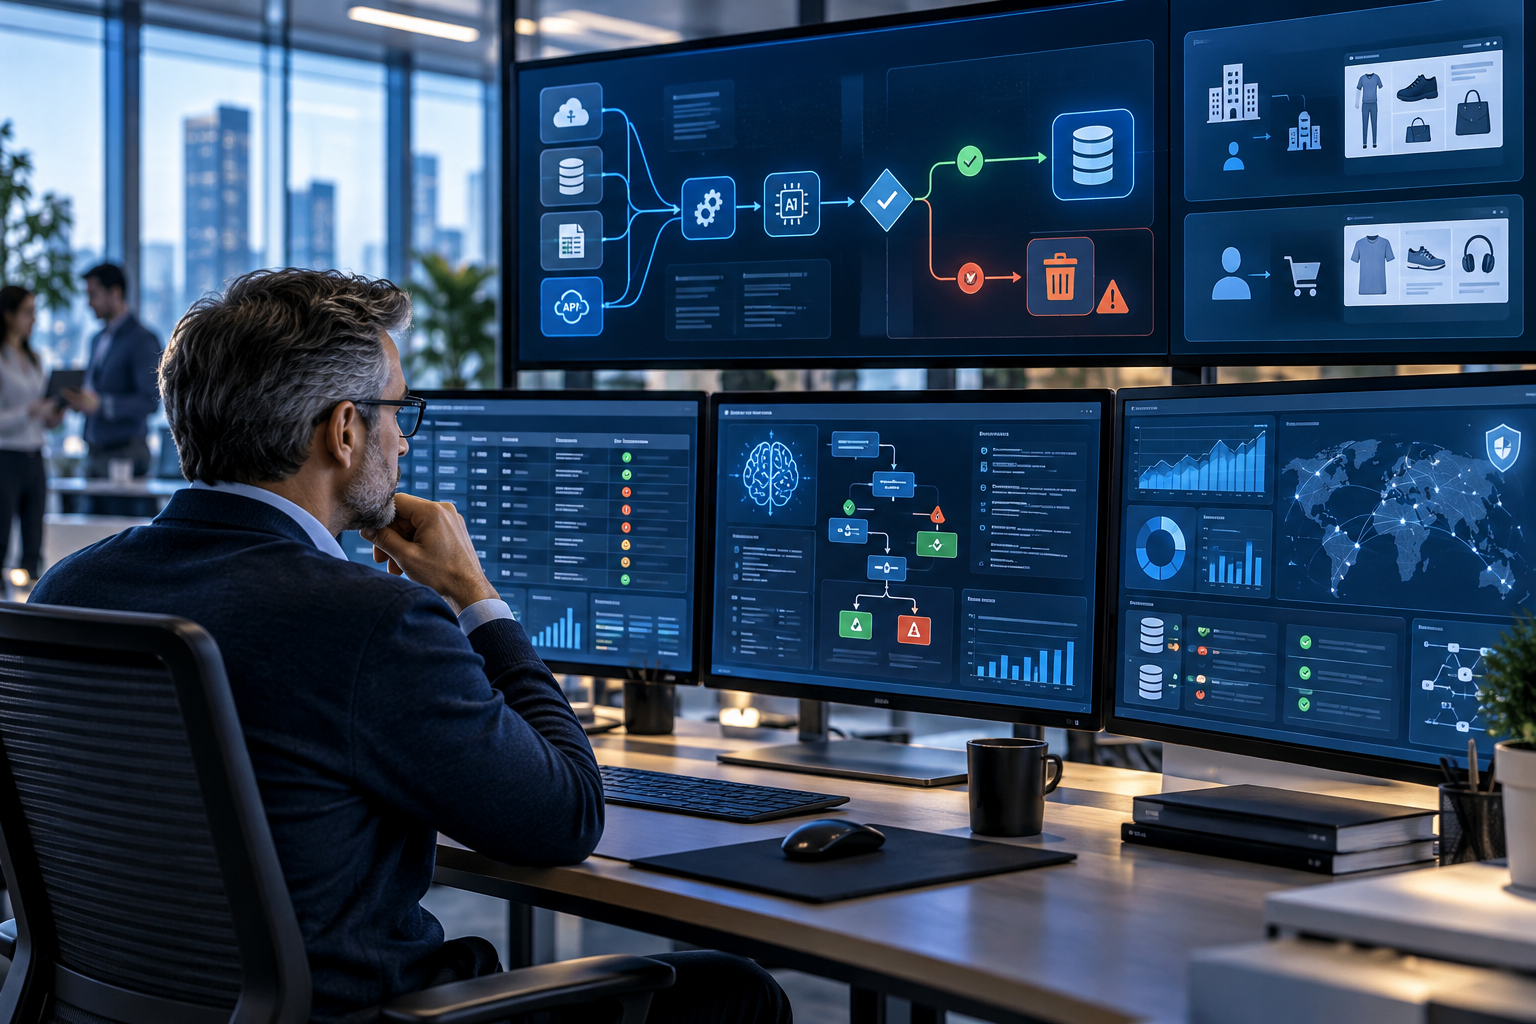
Binnen enterprise marketingtechnologie groeit de druk om steeds meer processen te automatiseren. Organisaties koppelen Large Language Models aan CRM-platformen, verrijken klantprofielen met externe databronnen, laten content genereren op basis van API-input en bouwen besluitvorming in journeys die grotendeels zonder menselijke tussenkomst draaien. Technisch is er steeds meer mogelijk. Daardoor verschuift het grootste risico van de automatisering naar de kwaliteit, betekenis en governance van de data waarop die automatisering vertrouwt. Moderne systemen kunnen overtuigend ogen terwijl de onderliggende logica niet klopt. Een dashboard kan exact rekenen, een gegenereerde tekst kan professioneel lezen en een visual kan een plausibel verhaal ondersteunen. Toch kan één verkeerde productdefinitie, ontbrekende autorisatieregel of foutieve context zich door een complete keten verspreiden en meerdere processen tegelijk raken. De grootste kwetsbaarheid van AI-gedreven automation is daarom niet dat systemen fouten kunnen maken, maar dat zij fouten snel, consistent en geloofwaardig kunnen vermenigvuldigen. Daarmee wordt het klassieke principe garbage in, garbage out opnieuw actueel. Niet omdat organisaties te weinig technologie hebben, maar omdat generatieve AI en integratiearchitecturen de verspreiding van slechte data versnellen. Wie betrouwbare automatisering wil bouwen, moet daarom verder kijken dan technische connectiviteit alleen. De vraag is niet uitsluitend of systemen data kunnen uitwisselen, maar of de betekenis van die data tijdens iedere stap behouden blijft.Een fout die er professioneel uitziet, blijft een fout
Een illustratief praktijkvoorbeeld is een automatisch gegenereerde infographic waarin een historische prijsevolutie over meer dan veertig jaar werd vergeleken. De presentatie oogde verzorgd en kwantitatief onderbouwd. Er stonden bedragen, percentages en een nette tijdlijn in. Aanvankelijk leek er weinig aanleiding om de uitkomst ter discussie te stellen. Bij nadere controle bleek echter dat verschillende databronnen en objectdefinities door elkaar liepen. De historische prijs had betrekking op een los product, terwijl de moderne prijs was gekoppeld aan een samengesteld aanbod met aanvullende componenten en andere verkoopvoorwaarden. Ook de historische valuta-informatie was onvoldoende gecontroleerd. Het model had verschillende contexten samengebracht tot één cijfermatige vergelijking die intern consistent leek, maar methodologisch niet zuiver was. Een systeem kan rekenkundig correct functioneren en toch inhoudelijk een verkeerde conclusie produceren. Dat gebeurt wanneer validatie zich beperkt tot het formaat van een veld, terwijl de semantiek buiten beeld blijft. Een geldige numerieke waarde zegt zonder context nog niets over productvorm, verkoopkanaal, btw, verzendkosten, contractvoorwaarden of historische vergelijkbaarheid. Voor enterprise-architecturen betekent dit dat technische validatie moet worden aangevuld met functionele en contextuele controles. Vier vragen helpen om die controle concreet te maken:- Vergelijken we daadwerkelijk hetzelfde product, aanbod of object?
- Hoort de prijs of status bij hetzelfde verkoopkanaal en dezelfde doelgroep?
- Is de historische of commerciële context inhoudelijk vergelijkbaar?
- Is de gebruikte bron leidend voor deze specifieke toepassing?
LLM-hallucinaties ontstaan niet alleen in het model
In discussies over generatieve AI wordt hallucinatie vaak behandeld alsof het uitsluitend een eigenschap van het taalmodel is. In enterprise-omgevingen is dat te beperkt. Een LLM kan informatie verzinnen of aannames afmaken zonder betrouwbare grondslag, maar veel fouten ontstaan eerder in de architectuur eromheen: in de keuze van bronnen, de datamapping, de metadata, de autorisatielaag of de logica waarmee context wordt opgebouwd. Een model dat via een integratie werkt, ontvangt bijvoorbeeld gegevens uit een productfeed, CRM-object, datalake of externe API. Als de semantiek van die gegevens niet expliciet is vastgelegd, moet het model zelf verbanden leggen. Een prijsveld zonder aanvullende metadata zegt niet of het bedrag inclusief btw is, of verzendkosten zijn inbegrepen, of het om B2B of B2C gaat, of de prijs tijdelijk is en of het product daadwerkelijk beschikbaar is voor het account dat de data opvraagt. Voor een mens zijn zulke verschillen vaak vanzelfsprekend. Voor een systeem zijn het afzonderlijke attributen die expliciet moeten worden gemodelleerd. Ontbreekt die context, dan kan een generatief model overtuigend klinken terwijl de gekozen interpretatie niet klopt.Een technisch succesvolle API-call bewijst dat systemen kunnen communiceren. Zij bewijst niet dat de ontvangen data functioneel geschikt is voor de beslissing die erop volgt.Daarom moet een enterprise-architectuur onderscheid maken tussen connectiviteit en betrouwbaarheid. Een endpoint kan perfect bereikbaar zijn en toch ongeschikte data leveren. Een integratie is pas bruikbaar wanneer data niet alleen technisch valide is, maar ook functioneel overeenkomt met de businesscontext waarin zij wordt toegepast. Voor marketingorganisaties is dat bijzonder relevant. Zodra generatieve AI wordt gekoppeld aan Salesforce, Marketing Cloud, Account Engagement, commerce-platformen of externe databronnen, kan een foutieve classificatie journeys verkeerd activeren, verkeerde doelgroepen selecteren, niet-beschikbare producten promoten of rapportages produceren die intern als waarheid worden gebruikt. De fout verschuift dan van contentniveau naar procesniveau.
Dezelfde SKU is niet altijd hetzelfde aanbod
Een tweede praktijkpatroon laat zien waarom traditionele datamatching onvoldoende kan zijn. Stel dat een fabrikant of leverancier hetzelfde product op een consumentenwebsite en in een zakelijke portal voert. De EAN-code en SKU zijn identiek. Een eenvoudige integratie concludeert dan dat het om hetzelfde beschikbare product gaat. Technisch klopt die identificatie, maar commercieel hoeft het aanbod niet gelijk te zijn. Een leverancier kan een product op de B2C-website actief aanbieden en tegelijkertijd voor zakelijke partners blokkeren, beperken tot bepaalde accounts of in de B2B-portal als niet beschikbaar markeren. Daar kunnen bewuste commerciële redenen achter zitten: kanaalstrategie, margesturing, contractvoorwaarden, voorraadprioritering of distributierechten. Voor een generieke feed bestaat het product. Voor het betreffende zakelijke account bestaat het aanbod feitelijk niet. Wanneer een geautomatiseerde cataloguspipeline alleen kijkt naar EAN, SKU, prijs en generieke voorraadstatus, ontstaat catalogusvervuiling. Het systeem synchroniseert een product dat voor de relevante klantgroep niet bestelbaar is. Die fout kan vervolgens doorwerken naar commerce, campagnes, voorraadcommunicatie, klantenservice en rapportage. Dit type probleem wordt vaak pas zichtbaar nadat een organisatie al veel automatisering heeft gebouwd. Technische teams zien een correct gematchte identifier, terwijl operations constateert dat het product niet geleverd kan worden. De architectuur faalt omdat beschikbaarheid ten onrechte als één universeel attribuut is gemodelleerd.B2B- en B2C-rechten horen in het datamodel
Enterprise-architectuur wordt robuuster wanneer beschikbaarheid niet als één binair veld wordt behandeld, maar als een combinatie van voorwaarden. De relevante vraag is niet alleen is dit product op voorraad? De betere vraag is: is dit product beschikbaar voor dit account, binnen dit kanaal, onder deze commerciële voorwaarden, op dit moment? Daarvoor moet het datamodel meer context bevatten dan alleen productidentificatie en voorraad. Accounttype, klantsegment, verkoopkanaal, contractstatus, catalogusrechten, voorraad per distributiecontext, prijsregels en geldigheidsperiode kunnen bepalend zijn voor de vraag of een record daadwerkelijk mag worden geactiveerd. Pas wanneer zulke attributen als afzonderlijke businessregels beschikbaar zijn, kan een integratielaag betrouwbaar bepalen of een record mag doorstromen naar een webshop, campagne, salesproces of AI-toepassing. Hier ligt ook het onderscheid tussen integratie, harmonisatie en activatie. Een middleware- of integratielaag, bijvoorbeeld via MuleSoft of andere API-orchestratie, kan data ophalen en operationele regels toepassen. Salesforce Data Cloud kan vervolgens data uit verschillende bronnen harmoniseren en beschikbaar maken voor segmentatie en activatie. Marketing Cloud en Account Engagement kunnen die gevalideerde context daarna gebruiken in communicatie en journeys. Geen van deze lagen vervangt de noodzaak om de businessregels vooraf goed te definiëren. Een Data Cloud-implementatie corrigeert geen verkeerde brondefinitie vanzelf. Als een beschikbaarheidsveld semantisch onjuist is gemodelleerd, ontstaat vooral een consistenter verspreide fout.Een Single Source of Truth is meer dan één database
Veel organisaties streven naar een Single Source of Truth. Dat begrip wordt soms teruggebracht tot één centrale database of één leidend CRM-record, maar één centrale plek kan nog steeds verkeerde, verouderde of contextloze informatie bevatten. Centralisatie creëert pas waarde als duidelijk is welke bron voor welk attribuut leidend is en onder welke voorwaarden die bron mag worden gebruikt. Voor prijsdata kan een ERP leidend zijn, voor marketingtoestemming een consentmanagementsysteem en voor accountrechten een contract- of commerceplatform. De waarheid bestaat dan niet uit één applicatie, maar uit afspraken over bronautoriteit, actualiteit, datagebruik en geldigheid. Dit wordt extra belangrijk wanneer LLM’s als interface bovenop meerdere databronnen worden geplaatst. Een model kan in één antwoord informatie combineren uit CRM, supportdata, productcatalogi en externe bronnen. Zonder duidelijke bronprioriteit kan het conflicterende gegevens samenvoegen tot een antwoord dat geloofwaardig klinkt, maar nergens exact als gevalideerde waarheid bestaat. In enterprise-omgevingen moet daarom niet alleen worden vastgelegd waar data vandaan komt, maar ook waarom die bron voor die context vertrouwd wordt. Data lineage, bronprioriteit, timestamps, validatiestatus en toegangsrechten zijn daarmee geen administratieve bijzaken, maar functionele onderdelen van AI-governance.Van datavalidatie naar fouttolerante architectuur
Datavalidatie wordt traditioneel vaak gezien als een technische controle op verplichte velden, datatypes, formaten en duplicaten. Voor AI-gedreven marketingprocessen is een bredere benadering nodig. De architectuur moet ook semantische, commerciële en contextuele afwijkingen kunnen herkennen en daar veilig op reageren.Een organisatie kan bijvoorbeeld een prijs controleren op datatype en valuta, maar daarnaast toetsen of de afwijking ten opzichte van de vorige periode aannemelijk is. Een productfeed kan technisch volledig zijn, maar alsnog worden geblokkeerd wanneer de B2B-entitlement ontbreekt. Een LLM-output kan syntactisch correct zijn, maar teruggestuurd worden naar review als brononderbouwing ontbreekt of verschillende databronnen elkaar tegenspreken. De stap van validatie naar fouttolerantie betekent bovendien dat systemen niet alleen fouten detecteren, maar een veilige vervolgstap kennen. Een onzeker record wordt in quarantaine geplaatst in plaats van gepubliceerd. Een ontbrekende autorisatiestatus blokkeert activatie. Een model mag bij onvoldoende bewijs geen waarde verzinnen, maar moet terugvallen op onbekend, aanvullende broncontrole of menselijke beoordeling.
| Architectuurlaag | Veelvoorkomend risico | Benodigde controle |
|---|---|---|
| Brondata | Verouderde, contextloze of conflicterende records | Bronautoriteit, timestamps en datakwaliteitsregels |
| API en integratie | Technisch geldige maar functioneel onjuiste data | Businessregels, entitlements en kanaallogica |
| Harmonisatie | Verkeerde records worden correct samengevoegd | Semantisch datamodel en bronprioriteit |
| LLM- en AI-laag | Hallucinatie of onterechte aanvulling | Grounding, broncontrole en confidence-drempels |
| Activatie | Foutieve output bereikt klant of medewerker | Approval flows, quarantaineregels en monitoring |
De menselijke data-steward blijft noodzakelijk
De oplossing is niet om automatisering terug te draaien, maar om de punten te definiëren waarop menselijke expertise de meeste waarde toevoegt. Een data-steward of functioneel verantwoordelijke ziet vaak iets wat een systeem niet vanzelf begrijpt: een prijsstijging kan technisch correct maar commercieel onwaarschijnlijk zijn; een product kan publiek zichtbaar zijn maar contractueel niet leverbaar; een historisch bedrag kan juist omgerekend zijn maar bij een ander aanbod horen. Die controle hoeft niet te betekenen dat iedere individuele output handmatig wordt beoordeeld. Enterprise-level governance richt zich juist op het identificeren van uitzonderingen waarbij menselijke tussenkomst nodig is. Denk aan conflicterende brondata, lage confidence-scores, ongebruikelijke prijswijzigingen, nieuwe productcategorieën, wijzigingen in accountrechten of situaties waarin meerdere systemen elkaar tegenspreken. Een volwassen architectuur maakt zulke uitzonderingen zichtbaar voordat een proces volledig wordt geautomatiseerd. Human-in-the-loop is dan geen noodrem achteraf, maar een ontwerpeis. De mens controleert niet elk record, maar bepaalt de grenzen waarbinnen het systeem autonoom mag handelen. Voor die governance zijn enkele ontwerpprincipes bijzonder belangrijk:- Maak onderscheid tussen gecontroleerde brondata, afgeleide data en door AI gegenereerde data.
- Registreer bron, tijdstip en validatiestatus bij gegevens die downstream worden gebruikt.
- Definieer expliciet welke uitzonderingen menselijke review vereisen.
- Voorkom dat onzekere AI-output automatisch masterdata overschrijft.
Wat dit betekent voor Salesforce-architecturen
Binnen het Salesforce-ecosysteem wordt steeds meer data beschikbaar voor segmentatie, personalisatie, AI en geautomatiseerde activatie. Dat biedt grote kansen, maar maakt governance niet minder belangrijk. Integendeel: hoe meer onderdelen met elkaar verbonden zijn, hoe groter het effect van een fout die vroeg in de keten ontstaat. Voor een architectuur met Sales Cloud, Data Cloud, Marketing Cloud en Account Engagement moet daarom vooraf duidelijk zijn welke systemen records creëren, welke systemen records mogen verrijken en welke systemen uitsluitend gevalideerde output consumeren. Ook moet worden voorkomen dat door AI gegenereerde data ongemerkt dezelfde status krijgt als gecontroleerde brondata. Een praktisch ontwerp kan daarom werken met afzonderlijke velden, objectstatussen of validatiestappen voor brondata, afgeleide data en gegenereerde data. AI-output kan prima worden ingezet voor suggesties, samenvattingen, classificatie of verrijking, maar hoeft niet automatisch de masterdata te overschrijven. Pas na validatie kan een record promoveren naar een status die downstream-processen mogen gebruiken.De waarde van AI ontstaat niet wanneer het systeem alles autonoom mag invullen, maar wanneer duidelijk is welke beslissingen het zelfstandig mag nemen en welke niet.Dat onderscheid is essentieel voor organisaties die generatieve AI serieus willen operationaliseren. Een proof of concept kan snel indrukwekkend zijn, maar enterprise-waarde ontstaat pas wanneer architectuur, governance en functionele werkelijkheid op elkaar aansluiten. Datamodellering, rechtenstructuren, bronprioriteit, uitzonderingslogica en monitoring zijn minder zichtbaar dan een AI-interface, maar bepalen uiteindelijk of de oplossing betrouwbaar blijft.
Van meer automatisering naar betere automatisering
De volwassen volgende stap in marketing automation is niet dat zoveel mogelijk menselijke controle verdwijnt. Het is dat organisaties precies weten waar menselijke controle noodzakelijk blijft en waar technologie veilig kan opschalen. Dat vraagt om architecturen waarin data niet alleen wordt verzameld, maar ook wordt gekwalificeerd; waarin API’s niet alleen verbinden, maar ook commerciële context doorgeven; en waarin AI niet uitsluitend wordt beoordeeld op overtuigingskracht, maar op herleidbaarheid. Voor CloudEngagePro ligt juist daar het snijvlak tussen marketingtechnologie, data-engineering en functionele bedrijfskennis. Salesforce-platformen kunnen processen vergaand automatiseren, maar alleen wanneer de architectuur rekening houdt met de werkelijkheid achter de data: klantrollen, catalogusrechten, prijslogica, historische context, bronbetrouwbaarheid en menselijke uitzonderingen. Garbage in, garbage out is daarmee geen verouderde IT-uitdrukking. In het tijdperk van generatieve AI is het een enterprise-risico dat sneller, overtuigender en op grotere schaal kan optreden dan ooit. Organisaties die AI en marketing automation duurzaam willen inzetten, creëren daarom niet de meeste waarde door zoveel mogelijk data te verzamelen of zoveel mogelijk processen autonoom te maken. Zij creëren waarde door data betrouwbaar te maken voordat automatisering ermee aan het werk gaat.Gerelateerde onderwerpen binnen Salesforce Marketing Cloud:
Marketing governance maakt Salesforce-automatisering bestuurbaar
Waarom expliciete besluitrechten, betrouwbare data en governance noodzakelijk zijn om marketing automation schaalbaar en controleerbaar te houden.
Revenue operations verbindt Salesforce-data met commerciële waarde
Hoe gedeelde definities, betrouwbare databronnen en gecontroleerde integraties voorkomen dat losse systemen verschillende commerciële werkelijkheden creëren.
Account Engagement vraagt om betrouwbare data, governance en controle
Waarom datakwaliteit, één leidende waarheid, integraties en expliciet eigenaarschap nodig zijn voor schaalbare en controleerbare marketing automation.