

Garbage in, garbage out: Warum KI und Marketing Automation ohne Datenverifizierung scheitern
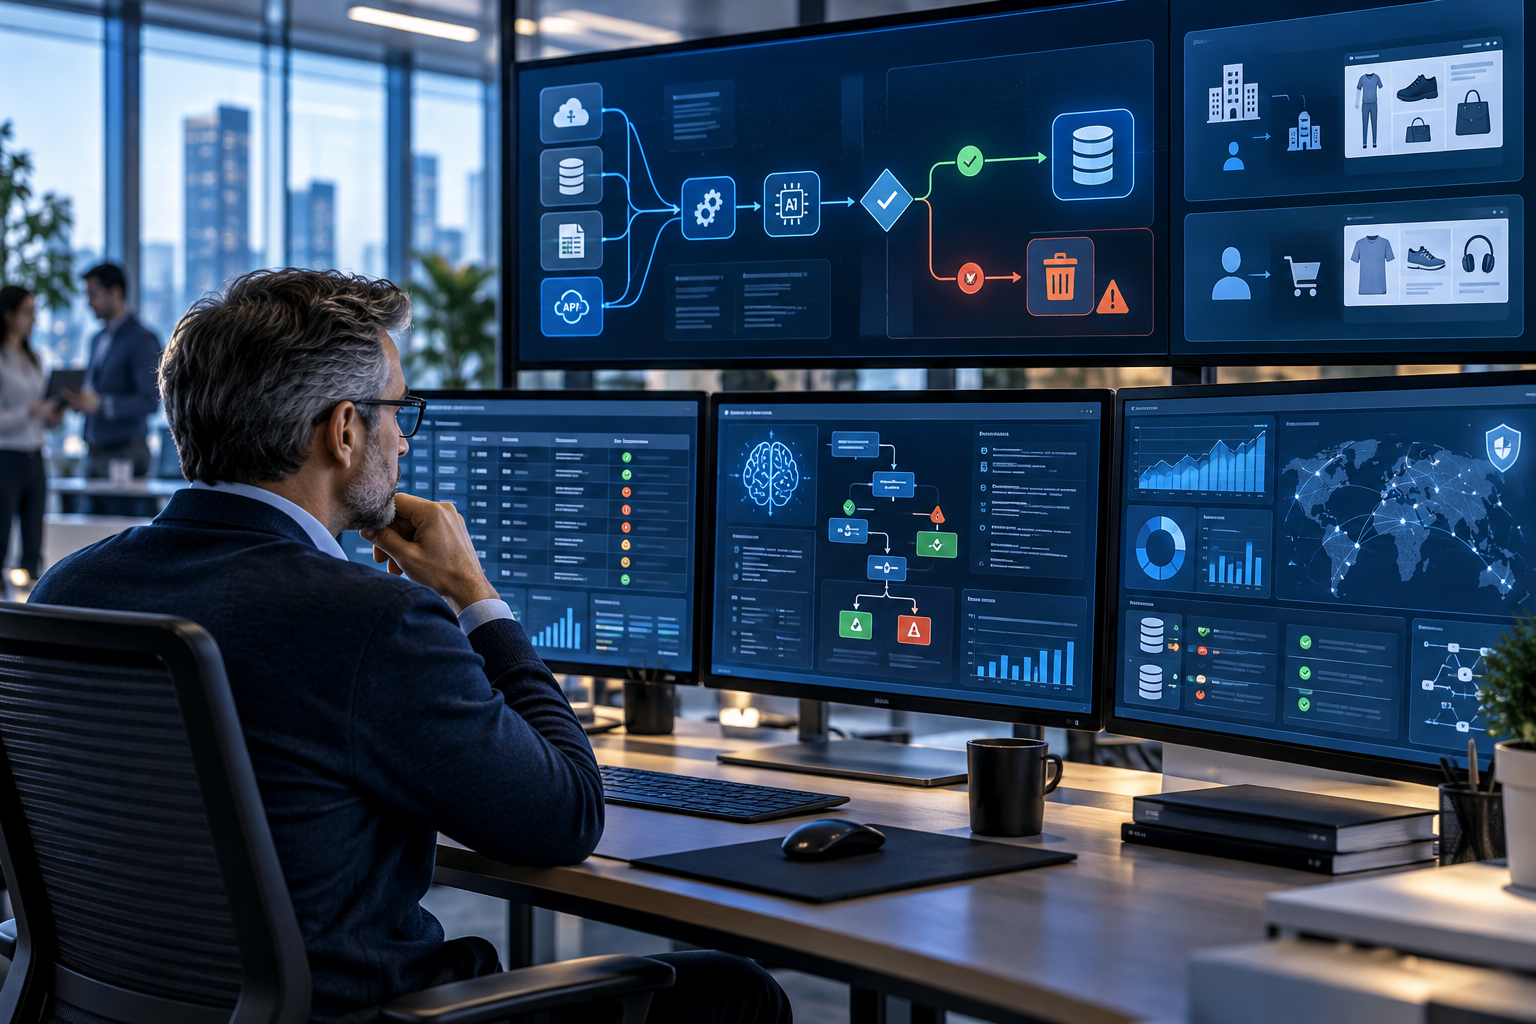
Im Bereich der Enterprise-Marketingtechnologie wächst der Druck, immer mehr Prozesse zu automatisieren. Unternehmen verbinden Large Language Models mit CRM-Plattformen, reichern Kundenprofile mit externen Datenquellen an, lassen Inhalte auf Basis von API-Input generieren und integrieren Entscheidungslogik in Journeys, die weitgehend ohne menschliches Eingreifen ablaufen. Technisch ist immer mehr möglich. Dadurch verlagert sich das größte Risiko der Automatisierung auf die Qualität, Bedeutung und Governance der Daten, auf denen diese Automatisierung basiert. Moderne Systeme können überzeugend wirken, obwohl die zugrunde liegende Logik fehlerhaft ist. Ein Dashboard kann exakt rechnen, ein generierter Text kann professionell formuliert sein und eine Visualisierung kann eine plausible Geschichte unterstützen. Dennoch kann sich eine einzige falsche Produktdefinition, eine fehlende Berechtigungsregel oder ein fehlerhafter Kontext durch eine gesamte Prozesskette verbreiten und mehrere Prozesse gleichzeitig beeinträchtigen. Die größte Schwachstelle KI-gestützter Automatisierung besteht daher nicht darin, dass Systeme Fehler machen können, sondern darin, dass sie diese Fehler schnell, konsistent und überzeugend vervielfachen können. Damit wird das klassische Prinzip garbage in, garbage out wieder hochaktuell. Nicht weil Unternehmen zu wenig Technologie einsetzen, sondern weil generative KI und Integrationsarchitekturen die Verbreitung schlechter Daten beschleunigen. Wer zuverlässige Automatisierung aufbauen möchte, muss daher über reine technische Konnektivität hinausblicken. Entscheidend ist nicht nur, ob Systeme Daten austauschen können, sondern ob die Bedeutung dieser Daten in jedem Verarbeitungsschritt erhalten bleibt.Ein Fehler, der professionell aussieht, bleibt ein Fehler
Ein anschauliches Praxisbeispiel ist eine automatisch generierte Infografik, in der eine historische Preisentwicklung über einen Zeitraum von mehr als vierzig Jahren verglichen wurde. Die Darstellung wirkte professionell und quantitativ fundiert. Sie enthielt Beträge, Prozentsätze und eine übersichtliche Zeitachse. Zunächst gab es wenig Anlass, das Ergebnis infrage zu stellen. Bei genauerer Prüfung zeigte sich jedoch, dass unterschiedliche Datenquellen und Objektdefinitionen miteinander vermischt worden waren. Der historische Preis bezog sich auf ein einzelnes Produkt, während der aktuelle Preis mit einem Paketangebot verknüpft war, das zusätzliche Komponenten und andere Verkaufsbedingungen umfasste. Auch die historischen Währungsinformationen waren nicht ausreichend überprüft worden. Das Modell hatte unterschiedliche Kontexte zu einem einzigen Zahlenvergleich zusammengeführt, der intern konsistent wirkte, methodisch jedoch nicht sauber war. Ein System kann mathematisch korrekt funktionieren und dennoch inhaltlich zu einer falschen Schlussfolgerung gelangen. Das geschieht, wenn sich die Validierung lediglich auf das Format eines Feldes beschränkt, während die Semantik unberücksichtigt bleibt. Ein gültiger numerischer Wert sagt ohne Kontext noch nichts über Produktform, Vertriebskanal, Mehrwertsteuer, Versandkosten, Vertragsbedingungen oder historische Vergleichbarkeit aus. Für Enterprise-Architekturen bedeutet dies, dass technische Validierung durch funktionale und kontextbezogene Kontrollen ergänzt werden muss. Vier Fragen helfen dabei, diese Kontrolle konkret zu gestalten:- Vergleichen wir tatsächlich dasselbe Produkt, Angebot oder Objekt?
- Gehören Preis oder Status zum selben Vertriebskanal und zur selben Zielgruppe?
- Ist der historische oder kommerzielle Kontext inhaltlich wirklich vergleichbar?
- Ist die verwendete Quelle für diese spezifische Anwendung maßgeblich?
LLM-Halluzinationen entstehen nicht nur im Modell
In Diskussionen über generative KI wird Halluzination häufig so behandelt, als wäre sie ausschließlich eine Eigenschaft des Sprachmodells selbst. In Enterprise-Umgebungen greift diese Sichtweise zu kurz. Ein LLM kann Informationen erfinden oder Annahmen ohne verlässliche Grundlage vervollständigen, doch viele Fehler entstehen bereits früher in der umgebenden Architektur: bei der Auswahl der Quellen, beim Daten-Mapping, in den Metadaten, in der Berechtigungsebene oder in der Logik, mit der Kontext aufgebaut wird. Ein Modell, das über eine Integration arbeitet, erhält beispielsweise Daten aus einem Produktfeed, CRM-Objekt, Data Lake oder einer externen API. Wenn die Semantik dieser Daten nicht explizit definiert ist, muss das Modell die Zusammenhänge selbst ableiten. Ein Preisfeld ohne ergänzende Metadaten sagt nicht aus, ob der Betrag die Mehrwertsteuer enthält, ob Versandkosten berücksichtigt sind, ob er für B2B oder B2C gilt, ob der Preis zeitlich begrenzt ist oder ob das Produkt für das Konto, das die Daten abfragt, tatsächlich verfügbar ist. Für einen Menschen erscheinen solche Unterschiede oft selbstverständlich. Für ein System handelt es sich um separate Attribute, die explizit modelliert werden müssen. Fehlt dieser Kontext, kann ein generatives Modell sehr überzeugend klingen, obwohl die gewählte Interpretation falsch ist.Ein technisch erfolgreicher API-Aufruf beweist, dass Systeme miteinander kommunizieren können. Er beweist nicht, dass die empfangenen Daten funktional für die darauf folgende Entscheidung geeignet sind.Eine Enterprise-Architektur muss daher zwischen Konnektivität und Zuverlässigkeit unterscheiden. Ein Endpoint kann technisch einwandfrei erreichbar sein und dennoch ungeeignete Daten liefern. Eine Integration ist erst dann wirklich nutzbar, wenn die Daten nicht nur technisch valide sind, sondern auch funktional zum Geschäftskontext passen, in dem sie eingesetzt werden. Für Marketingorganisationen ist dies besonders relevant. Sobald generative KI mit Salesforce, Marketing Cloud, Account Engagement, Commerce-Plattformen oder externen Datenquellen verbunden wird, kann eine fehlerhafte Klassifizierung Journeys falsch aktivieren, falsche Zielgruppen auswählen, nicht verfügbare Produkte bewerben oder Berichte erzeugen, die intern als Wahrheit behandelt werden. Der Fehler verlagert sich damit von der Inhaltsebene auf die Prozessebene.
Dieselbe SKU steht nicht immer für dasselbe Angebot
Ein zweites Praxismuster zeigt, warum traditionelles Daten-Matching unzureichend sein kann. Angenommen, ein Hersteller oder Lieferant führt dasselbe Produkt sowohl auf einer Verbraucherwebsite als auch in einem Geschäftskundenportal. EAN-Code und SKU sind identisch. Eine einfache Integration kommt daher zu dem Schluss, dass es sich um dasselbe verfügbare Produkt handelt. Technisch ist diese Identifikation korrekt, kommerziell muss das Angebot jedoch nicht identisch sein. Ein Lieferant kann ein Produkt auf seiner B2C-Website aktiv anbieten und es gleichzeitig für Geschäftspartner sperren, auf bestimmte Accounts beschränken oder im B2B-Portal als nicht verfügbar kennzeichnen. Dahinter können bewusste kommerzielle Entscheidungen stehen, etwa Kanalstrategie, Margensteuerung, Vertragsbedingungen, Bestandspriorisierung oder Vertriebsrechte. Für einen generischen Feed existiert das Produkt. Für den betreffenden Geschäftskunden existiert das Angebot faktisch nicht. Wenn eine automatisierte Katalog-Pipeline ausschließlich EAN, SKU, Preis und einen allgemeinen Lagerstatus berücksichtigt, entsteht eine Verunreinigung des Produktkatalogs. Das System synchronisiert ein Produkt, das von der relevanten Kundengruppe tatsächlich nicht bestellt werden kann. Dieser Fehler kann anschließend auf Commerce, Kampagnen, Bestandskommunikation, Kundenservice und Reporting durchschlagen. Dieses Problem wird häufig erst sichtbar, nachdem ein Unternehmen bereits umfangreiche Automatisierung aufgebaut hat. Technische Teams sehen einen korrekt zugeordneten Identifier, während Operations feststellt, dass das Produkt nicht geliefert werden kann. Die Architektur scheitert, weil Verfügbarkeit fälschlicherweise als ein einziges universelles Attribut modelliert wurde.B2B- und B2C-Berechtigungen gehören in das Datenmodell
Eine Enterprise-Architektur wird robuster, wenn Verfügbarkeit nicht als einzelnes binäres Feld behandelt wird, sondern als Kombination mehrerer Bedingungen. Die relevante Frage lautet nicht nur ist dieses Produkt auf Lager? Die bessere Frage lautet: Ist dieses Produkt für diesen Account, über diesen Kanal, zu diesen kommerziellen Bedingungen und zu diesem Zeitpunkt verfügbar? Das Datenmodell benötigt daher mehr Kontext als lediglich Produktidentifikation und Bestand. Account-Typ, Kundensegment, Vertriebskanal, Vertragsstatus, Katalogberechtigungen, Bestand je Distributionskontext, Preisregeln und Gültigkeitszeiträume können darüber entscheiden, ob ein Datensatz tatsächlich aktiviert werden darf. Erst wenn solche Attribute als separate Geschäftsregeln verfügbar sind, kann eine Integrationsschicht zuverlässig bestimmen, ob ein Datensatz in einen Webshop, eine Kampagne, einen Sales-Prozess oder eine KI-Anwendung weitergegeben werden darf. Hier wird auch die Unterscheidung zwischen Integration, Harmonisierung und Aktivierung relevant. Eine Middleware- oder Integrationsschicht, beispielsweise über MuleSoft oder eine andere Form der API-Orchestrierung, kann Daten abrufen und operative Regeln anwenden. Salesforce Data Cloud kann anschließend Daten aus verschiedenen Quellen harmonisieren und für Segmentierung und Aktivierung verfügbar machen. Marketing Cloud und Account Engagement können diesen validierten Kontext danach für Kommunikation und Journeys nutzen. Keine dieser Ebenen ersetzt jedoch die Notwendigkeit, die Geschäftsregeln im Vorfeld korrekt zu definieren. Eine Data-Cloud-Implementierung korrigiert eine fehlerhafte Quelldefinition nicht automatisch. Wenn ein Verfügbarkeitsfeld semantisch falsch modelliert wurde, entsteht vor allem ein konsistenter verbreiteter Fehler.Eine Single Source of Truth ist mehr als nur eine Datenbank
Viele Unternehmen streben nach einer Single Source of Truth. Dieses Konzept wird manchmal auf eine zentrale Datenbank oder einen führenden CRM-Datensatz reduziert, doch auch ein zentraler Speicherort kann falsche, veraltete oder kontextlose Informationen enthalten. Zentralisierung schafft erst dann einen Mehrwert, wenn klar definiert ist, welche Quelle für welches Attribut führend ist und unter welchen Bedingungen diese Quelle verwendet werden darf. Für Preisdaten kann beispielsweise ein ERP-System führend sein, für Marketing-Einwilligungen ein Consent-Management-System und für Account-Berechtigungen eine Vertrags- oder Commerce-Plattform. Die Wahrheit befindet sich dann nicht in einer einzigen Anwendung, sondern in klaren Vereinbarungen über Quellenhoheit, Aktualität, Datennutzung und Gültigkeit. Dies wird besonders wichtig, wenn LLMs als Interface über mehreren Datenquellen eingesetzt werden. Ein Modell kann in einer einzigen Antwort Informationen aus CRM, Supportdaten, Produktkatalogen und externen Quellen zusammenführen. Ohne klare Quellenpriorisierung kann es widersprüchliche Daten zu einer Antwort kombinieren, die glaubwürdig klingt, aber an keiner Stelle als validierte Wahrheit existiert. In Enterprise-Umgebungen muss daher nicht nur dokumentiert werden, woher Daten stammen, sondern auch, warum genau diese Quelle für den jeweiligen Kontext als vertrauenswürdig gilt. Data Lineage, Quellenpriorität, Zeitstempel, Validierungsstatus und Zugriffsrechte sind damit keine administrativen Nebensächlichkeiten, sondern funktionale Bestandteile der KI-Governance.Von Datenvalidierung zu fehlertoleranter Architektur
Datenvalidierung wird traditionell häufig als technische Kontrolle von Pflichtfeldern, Datentypen, Formaten und Duplikaten verstanden. Für KI-gestützte Marketingprozesse ist ein breiterer Ansatz erforderlich. Die Architektur muss auch semantische, kommerzielle und kontextbezogene Abweichungen erkennen und sicher darauf reagieren können.Ein Unternehmen kann beispielsweise einen Preis auf Datentyp und Währung prüfen und zusätzlich bewerten, ob die Abweichung gegenüber der vorherigen Periode plausibel ist. Ein Produktfeed kann technisch vollständig sein und dennoch blockiert werden, wenn die erforderliche B2B-Berechtigung fehlt. Ein LLM-Output kann syntaktisch korrekt sein, aber zur Überprüfung zurückgesendet werden, wenn die Quellenbasis fehlt oder verschiedene Datenquellen einander widersprechen. Der Schritt von Validierung zu Fehlertoleranz bedeutet außerdem, dass Systeme Fehler nicht nur erkennen, sondern auch einen sicheren Folgeprozess kennen müssen. Ein unsicherer Datensatz wird unter Quarantäne gestellt, statt veröffentlicht zu werden. Ein fehlender Berechtigungsstatus blockiert die Aktivierung. Bei unzureichender Beweislage darf ein Modell keinen Wert erfinden, sondern muss auf unbekannt, zusätzliche Quellenprüfung oder menschliche Bewertung zurückgreifen.
| Architekturebene | Häufiges Risiko | Erforderliche Kontrolle |
|---|---|---|
| Quelldaten | Veraltete, kontextlose oder widersprüchliche Datensätze | Quellenhoheit, Zeitstempel und Datenqualitätsregeln |
| API und Integration | Technisch valide, aber funktional falsche Daten | Geschäftsregeln, Berechtigungen und Kanallogik |
| Harmonisierung | Fehlerhafte Datensätze werden korrekt zusammengeführt | Semantisches Datenmodell und Quellenpriorisierung |
| LLM- und KI-Ebene | Halluzination oder unbegründete Ergänzung | Grounding, Quellenprüfung und Confidence-Schwellenwerte |
| Aktivierung | Fehlerhafte Ausgabe erreicht Kunden oder Mitarbeitende | Approval-Flows, Quarantäneregeln und Monitoring |
Der menschliche Data Steward bleibt unverzichtbar
Die Lösung besteht nicht darin, Automatisierung zurückzudrehen, sondern die Punkte zu definieren, an denen menschliche Expertise den größten Mehrwert bietet. Ein Data Steward oder fachlich Verantwortlicher erkennt häufig etwas, das ein System nicht von selbst versteht: Eine Preiserhöhung kann technisch korrekt, aber kommerziell unplausibel sein; ein Produkt kann öffentlich sichtbar, aber vertraglich nicht lieferbar sein; ein historischer Betrag kann korrekt umgerechnet worden sein und sich dennoch auf ein anderes Angebot beziehen. Diese Kontrolle bedeutet nicht, dass jede einzelne Ausgabe manuell geprüft werden muss. Enterprise-Governance konzentriert sich vielmehr darauf, Ausnahmen zu identifizieren, bei denen menschliches Eingreifen erforderlich ist. Dazu gehören beispielsweise widersprüchliche Quelldaten, niedrige Confidence-Scores, ungewöhnliche Preisänderungen, neue Produktkategorien, Änderungen an Account-Berechtigungen oder Situationen, in denen mehrere Systeme einander widersprechen. Eine ausgereifte Architektur macht solche Ausnahmen sichtbar, bevor ein Prozess vollständig automatisiert wird. Human-in-the-loop ist dann keine Notbremse im Nachhinein, sondern eine explizite Designanforderung. Der Mensch kontrolliert nicht jeden Datensatz, sondern definiert die Grenzen, innerhalb derer das System autonom handeln darf. Für diese Governance sind einige Gestaltungsprinzipien besonders wichtig:- Unterscheiden Sie zwischen validierten Quelldaten, abgeleiteten Daten und KI-generierten Daten.
- Erfassen Sie Quelle, Zeitstempel und Validierungsstatus für Daten, die downstream verwendet werden.
- Definieren Sie explizit, welche Ausnahmen eine menschliche Prüfung erfordern.
- Verhindern Sie, dass unsicherer KI-Output automatisch Stammdaten überschreibt.
Was dies für Salesforce-Architekturen bedeutet
Innerhalb des Salesforce-Ökosystems stehen immer größere Datenmengen für Segmentierung, Personalisierung, KI und automatisierte Aktivierung zur Verfügung. Das eröffnet erhebliche Chancen, macht Governance jedoch nicht weniger wichtig. Im Gegenteil: Je mehr Komponenten miteinander verbunden sind, desto größer ist die Auswirkung eines Fehlers, der früh in der Prozesskette entsteht. Für eine Architektur mit Sales Cloud, Data Cloud, Marketing Cloud und Account Engagement muss daher im Vorfeld klar definiert sein, welche Systeme Datensätze erstellen, welche Systeme sie anreichern dürfen und welche Systeme ausschließlich validierte Ausgaben konsumieren dürfen. Außerdem muss verhindert werden, dass KI-generierte Daten unbemerkt denselben Status erhalten wie kontrollierte Quelldaten. Ein praktisches Design kann deshalb mit separaten Feldern, Objektstatus oder Validierungsschritten für Quelldaten, abgeleitete Daten und generierte Daten arbeiten. KI-Output kann sinnvoll für Empfehlungen, Zusammenfassungen, Klassifizierung oder Anreicherung eingesetzt werden, ohne automatisch die Stammdaten zu überschreiben. Erst nach einer Validierung sollte ein Datensatz in einen Status überführt werden, den nachgelagerte Prozesse verwenden dürfen.Der Wert von KI entsteht nicht dadurch, dass das System alles autonom ausfüllen darf, sondern dadurch, dass klar definiert ist, welche Entscheidungen es selbstständig treffen darf und welche nicht.Diese Unterscheidung ist entscheidend für Unternehmen, die generative KI ernsthaft operationalisieren möchten. Ein Proof of Concept kann schnell beeindruckend wirken, doch Enterprise-Mehrwert entsteht erst dann, wenn Architektur, Governance und funktionale Realität aufeinander abgestimmt sind. Datenmodellierung, Berechtigungsstrukturen, Quellenpriorität, Ausnahmelogik und Monitoring sind weniger sichtbar als ein KI-Interface, bestimmen aber letztlich, ob die Lösung zuverlässig bleibt.
Von mehr Automatisierung zu besserer Automatisierung
Der ausgereifte nächste Schritt in der Marketing Automation besteht nicht darin, möglichst viel menschliche Kontrolle zu beseitigen. Entscheidend ist vielmehr, genau zu wissen, wo menschliche Kontrolle notwendig bleibt und wo Technologie sicher skalieren kann. Dafür sind Architekturen erforderlich, in denen Daten nicht nur gesammelt, sondern auch qualifiziert werden; in denen APIs nicht nur Systeme verbinden, sondern auch kommerziellen Kontext transportieren; und in denen KI nicht ausschließlich nach ihrer Überzeugungskraft, sondern auch nach ihrer Nachvollziehbarkeit bewertet wird. Für CloudEngagePro liegt genau hier die Schnittstelle zwischen Marketingtechnologie, Data Engineering und funktionalem Business-Know-how. Salesforce-Plattformen können Prozesse weitgehend automatisieren, allerdings nur dann, wenn die Architektur die Realität hinter den Daten berücksichtigt: Kundenrollen, Katalogberechtigungen, Preislogik, historischen Kontext, Quellenzuverlässigkeit und menschliche Ausnahmen. Garbage in, garbage out ist damit keineswegs eine veraltete IT-Redewendung. Im Zeitalter generativer KI handelt es sich um ein Enterprise-Risiko, das schneller, überzeugender und in größerem Maßstab auftreten kann als je zuvor. Unternehmen, die KI und Marketing Automation nachhaltig einsetzen möchten, schaffen daher nicht den größten Mehrwert, indem sie möglichst viele Daten sammeln oder möglichst viele Prozesse autonom gestalten. Sie schaffen Mehrwert, indem sie Daten zuverlässig machen, bevor die Automatisierung damit arbeitet.Vertiefende Themen innerhalb der Salesforce Marketing Cloud:
Marketing Governance steuert Salesforce-Automatisierung
Warum klare Entscheidungsrechte, verlässliche Daten und Governance notwendig sind, um Marketing Automation skalierbar und kontrollierbar zu gestalten.
Revenue Operations verbindet Salesforce-Daten mit Geschäftswert
Wie gemeinsame Definitionen, verlässliche Datenquellen und kontrollierte Integrationen verhindern, dass getrennte Systeme unterschiedliche kommerzielle Realitäten erzeugen.
Account Engagement braucht verlässliche Daten und Governance

Warum Datenqualität, eine zentrale Datenwahrheit, Integrationen und klare Verantwortlichkeiten für skalierbare und kontrollierbare Marketing Automation entscheidend sind.